在国家 “人工智能 +” 战略与能源行业数智化转型政策驱动下,油气行业正加速从传统经验驱动向数据智能驱动跨越,AI 技术在测井解释、储层预测、钻井事故预警等场景的深度应用,使高质量数据集成为破解智能化发展瓶颈的核心要素。当前行业面临三大核心痛点:一是数据业务一致性缺失,多源异构数据(地质、物探、生产数据等)分散于数十类系统,缺乏统一语义标准与共享机制,形成 “数据孤岛”;二是大小模型协同边界模糊,通用大模型缺乏油气专业知识深度理解,专业小模型彼此孤立且数据复用率低;三是数据标注效率低下,传统人工标注模式难以满足小模型训练与大模型微调需求。
本文针对油气行业勘探开发全流程需求,首先构建 了“业务支撑 – 小模型训练 – 大模型微调” 三类高质量数据集分类体系,旨在明确各类数据集的应用边界、数据标准与技术实现路径。为实现这一目标,研究以五维业务本体建模思想为核心,融合 OSDU 开放架构,将油气全流程拆解为 4 万 + 最小业务节点,构建涵盖对象域、业务域、工作域、专业域、业务过程域的全维度本体模型;在此基础上整合业务数据、标准规范、知识案例、业务规则等资源,形成全息业务知识图谱,为三类数据集提供统一语义骨架。在此基础上,通过数据治理、特征工程、知识抽取等关键技术,分别实现业务支撑类、小模型训练类、大模型微调类数据集的标准化构建,有效解决了数据孤岛、标准不一、标注低效等行业痛点,为油气生产管理、智能建模、决策优化等场景提供了坚实的数据支撑,推动行业从数据清理向语义化、对象化、知识化的数据治理新阶段跨越。
针对三类数据集设计差异化技术路径:业务支撑类数据集通过 “多源接入 – 清洗修复 – 标准化 – 自动化质检” 全流程治理,保障数据完整性与业务一致性;小模型训练类数据集依托企业级特征仓库,实现时间、深度、地层等多维度粒度对齐,结合知识图谱完成自动化特征标注;大模型微调类数据集通过 15 类问答模板(定义类、流程类、因果类等)与大量油气专业语义词库,生成结构化问答对。
关键词:高质量数据集;五维业务本体建模;最小业务节点;知识图谱;人工智能;数据治理;OSDU;语义词库;问答对;
在政策引领下,油气行业作为能源安全的核心支柱,正加速从传统经验驱动向数据智能驱动转型,“人工智能 + 勘探开发”“人工智能 + 生产运维” 等应用场景日益广泛,智能化已成为行业高质量发展的核心引擎。
数据作为智能化转型的核心生产要素,其质量直接决定了模型训练效果与业务赋能价值。随着 AI 技术在油气行业的深入应用,从测井自动解释、储层预测等专业小模型,到覆盖全业务域的行业大模型,均对数据的准确性、完整性、一致性、业务关联性提出了更高要求。高质量数据集不仅是模型精准训练的基础,更是打通业务与技术链路、实现跨部门协同、构建智能决策闭环的关键前提。
然而,油气行业智能化进程中仍面临两大核心挑战:一是数据业务一致性挑战,产业链长、业务复杂导致数据来源分散,缺乏统一语义标准与治理体系,形成 “数据孤岛”,数据与业务链路断裂;二是大小模型定位边界模糊挑战,通用大模型缺乏专业知识深度理解,专业小模型彼此孤立,模型体系与真实数据未形成闭环,AI 技术与业务场景脱节。在此背景下,构建适配不同应用场景的高质量数据集,建立标准化构建与管理体系,成为破解行业智能化瓶颈的关键课题。
本文旨在针对油气行业智能化发展的核心需求,建立科学、系统的高质量数据集分类体系,明确各类数据集的应用领域、数据要求与技术标准。通过研究三类数据集的构建方法与关键技术,形成以五维业务本体模型为核心、知识图谱为支撑、数据治理为保障的全流程解决方案,解决数据业务不一致、模型数据不匹配、知识表达不规范等核心问题。
研究最终目标是为油气行业提供一套可落地、可扩展的高质量数据集构建框架,实现业务数据的标准化管理、建模数据的高效复用、知识数据的结构化表达,支撑日常业务系统稳定运行、小模型精准训练与大模型行业适配,推动行业智能化从技术探索向业务赋能深度转型,为油气行业全产业链智能升级提供数据基础与技术支撑。
本文提出 “一体三翼” 的油气高质量数据集构建整体框架,以油气五维业务本体模型为核心载体,构建统一的业务知识图谱与管理框架,在此基础上分别支撑三类数据集的标准化构建(见图 1)。
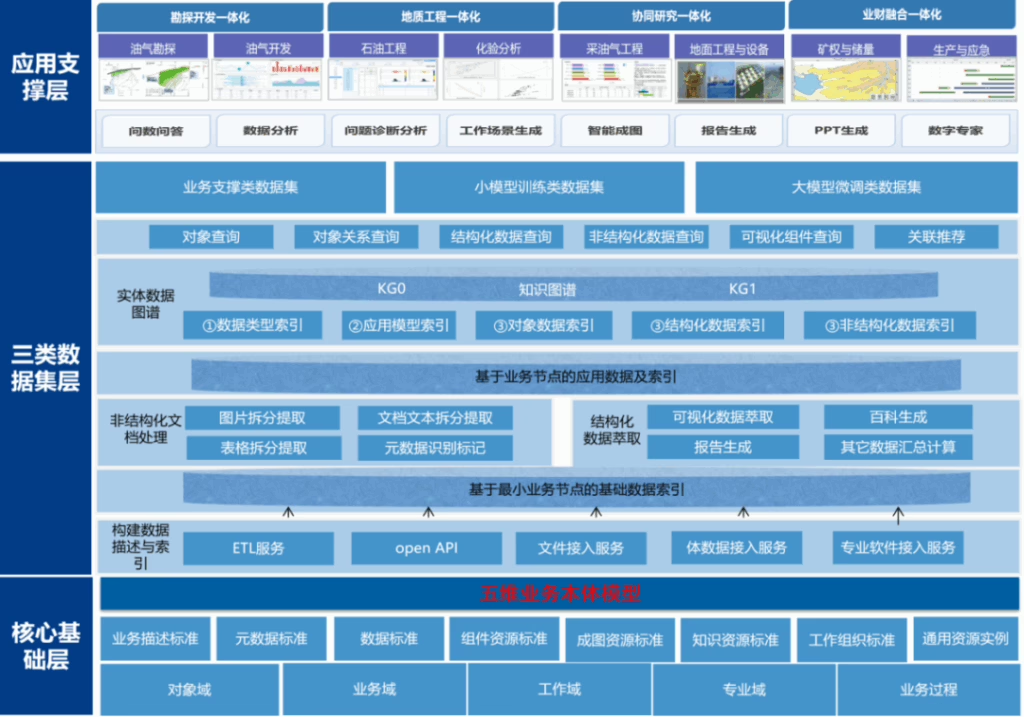
图 1 :油气高质量数据集构建整体框架
核心基础层以五维业务建模思想为指导,融合 OSDU 开放架构标准,构建涵盖对象域、业务域、工作域、专业域、业务过程域的全维度五维业务本体模型,将油气行业勘探、开发、生产全流程拆解为 4 万 + 最小业务节点,明确每个节点的输入数据、处理流程、输出成果及关联关系。基于该模型构建油气全息业务知识图谱,整合业务数据、标准规范、知识案例、业务规则、组件算法等多类资源,形成统一的语义骨架与数据管理平台,为三类数据集提供标准化的数据基础与关联支撑。
三类数据集层基于核心基础层,针对不同应用场景进行定制化构建:业务支撑类数据集聚焦日常业务系统运行需求,强调数据的完整性与业务一致性;小模型训练类数据集面向专业任务建模,突出特征的标准化与可复用性;大模型微调类数据集侧重行业知识表达,注重知识的结构化与语义准确性。
应用支撑层通过数据服务接口,构建一套基础智能服务,实现三类数据集与业务系统、小模型、大模型的无缝对接,形成 “数据 – 模型 – 业务” 的闭环管理。
1、支持日常业务应用系统的高质量业务数据集
(1)应用场景差异
此类数据集是油气企业信息化建设的基础支撑,主要服务于生产管理、储量评价、设备运维、合规审计等常规业务场景,适配 ERP、MES、PCS、储量管理系统等各类业务应用平台。其核心价值在于保障业务系统的稳定运行与高效协同,为日常业务决策提供真实、准确的数据支撑,例如单井生产日报统计、设备运维计划制定、储量动态评估等场景均依赖此类数据集的持续供给。
(2)核心数据要求
数据覆盖全面:需包含油气业务全流程数据,涵盖主数据(井号、区块、设备编码等)、事务数据(产量、压力、作业记录等)、参考数据(岩性代码、流体类型等)、标准规范、知识案例、业务规则等多类数据资源。
管理规范统一:严格遵循 “描述与存储分离” 原则,数据的业务描述信息与物理存储信息相互独立,通过元数据建立关联,确保数据管理的灵活性与扩展性。
元数据完备:所有数据均需具备完整的元数据背景信息,包括数据来源、采集时间、数据类型、精度要求、业务含义、关联关系等,能够通过元数据追溯业务对象全生命周期数据信息,实现业务关系精准定位。
质量达标:经过完整数据治理体系处理,满足准确性、完整性、一致性、唯一性、及时性、可追溯性六大核心质量指标,无错误记录、格式冲突、语义歧义等问题。
(3)技术实现路径
数据接入标准化:基于 OSDU 开放架构与 OiO 业务建模标准,建立多源数据统一接入协议,支持结构化数据库、非结构化文档、时序曲线、图像视频等多类型数据接入,通过格式转换引擎与语义映射层,实现不同系统数据的标准化适配。
全流程数据治理:构建 “接入 – 清洗 – 标准化 – 质检 – 归档” 全流程治理体系,开发自动化治理工具集。数据清洗阶段采用规则引擎与机器学习结合的方式,处理缺失值、异常值、重复值;标准化阶段统一数据术语、编码规则、量纲单位与数据格式;质检阶段建立覆盖六大质量维度的自动化质检规则库,利用 Drools 规则引擎定期扫描数据资产,输出质量问题清单与整改建议。
元数据体系建设:建立包含业务元数据、技术元数据、管理元数据的三维元数据体系,开发元数据管理工具,支持元数据的自动采集、手动录入、关联映射与版本管理,通过元数据实现数据的全生命周期追溯与业务关系定位。
数据存储与服务:采用 “数据湖 + 数据仓库” 混合存储架构,结构化数据存储于数据仓库,非结构化数据与时序数据存储于数据湖,通过统一数据服务接口,为业务系统提供查询、检索、统计等数据服务,确保数据的安全可控与高效访问。
2、支持大数据(小模型)建模的高质量数据集
(1)应用场景差异
此类数据集是连接原始业务数据与专业 AI 小模型的关键桥梁,面向特定专业任务构建主题型数据集,主要应用于测井自动解释、储层预测、钻井事故预警、产量预测、注采调控优化等场景。其核心价值在于为小模型训练提供标准化、高相关性的特征数据,解决小模型训练中数据准备周期长、特征一致性差、样本标注成本高等问题,提升模型训练效率与预测精度。
(2)核心数据要求
基于统一图谱:数据来源需依托油气全息业务知识图谱,确保数据的业务关联性与语义一致性,避免 “数据孤岛” 导致的模型泛化能力不足。
粒度标准化:不同类型、不同专业的数据需按照统一的粒度单元进行处理,支持时间粒度(日、月、年等)、深度粒度(米、分米、层位等)、事件粒度(事故类型、作业类型等)、网格粒度(平面网格、纵向网格等)等多维度粒度划分,确保数据的可融合性。
特征化与标签化:数据需经过特征工程处理,提取具备业务含义的特征值(如孔隙度、渗透率、泥质含量等),并基于业务知识图谱与历史案例进行自动标注,形成包含特征值与标签的结构化数据,直接适配机器学习框架输入要求。
可复用性:特征数据需集中管理,支持多模型共享复用,避免重复特征工程导致的效率低下与结果偏差,确保不同模型使用的特征值计算口径一致。
(3)技术实现路径
特征提取与标准化:基于业务知识图谱,识别建模所需的核心特征,开发专业化特征提取工具,支持滑动平均、傅里叶变换、分位数统计、层段聚合等多种特征提取算法,将原始业务数据转换为标准化特征值。针对不同粒度要求,采用最近邻重采样、线性插值、克里金插值等方法,实现多源数据的粒度对齐。
自动化特征标注:利用油气业务知识图谱中的实体关系与业务规则,实现特征数据的自动化标注。对于复杂场景,采用 “自动标注 + 专家审核” 的混合模式,通过业务元数据关联与历史事件匹配生成初始标签,经领域专家校验修正后形成最终标注结果,大幅降低人工标注成本。
特征仓库建设:构建企业级特征管理中心(Feature Hub),实现特征的注册、存储、管理与复用。每个特征分配唯一 ID,记录特征名称、描述、计算逻辑、数据来源、适用场景、版本信息等元数据,支持按关键词、业务场景、数据源等多维度检索,为不同建模任务提供特征快速调用服务。
数据集动态构建:基于知识图谱驱动的特征检索引擎,用户可根据建模任务需求,选择目标特征与粒度标准,系统自动关联并聚合相关特征数据,形成面向特定任务的训练数据集。支持数据集的筛选、排序、汇总计算等二次处理,以及 TensorFlow、PyTorch 等主流机器学习框架格式的导出。
数据集质量评估:建立 “特征质量 + 组合质量” 双维度评估体系,特征质量评估包括准确性、稳定性、无泄漏检测;组合质量评估通过相关系数矩阵、SHAP 值分析、交叉验证等方法,判断特征与目标变量的相关性及特征间的冗余程度,确保数据集的建模适配性。
3. 支持油气行业大模型(大语言模型)微调训练的行业知识高质量数据集
(1)应用场景差异
此类数据集聚焦油气行业专业知识的结构化表达,主要用于行业大模型的领域适应性微调,提升大模型在专业场景下的理解与推理能力。其核心应用场景包括专业知识问答、业务流程咨询、标准规范解读、研究报告自动生成、自然语言智能成图等,例如为工程师提供钻井事故处置方案咨询、自动生成储量评估报告框架、基于自然语言的智能数据成图等,助力业务人员提升工作效率,降低专业知识学习门槛。
(2)核心数据要求
知识覆盖全面:需基于油气全息业务知识图谱,涵盖业务数据、标准规范、知识案例、业务规则、业务组件算法等全类型知识资源,实现对勘探开发全流程业务的全息描述。
结构标准化:采用标准本体结构组织数据,明确业务节点、实体类型、关系类型等核心要素,确保知识表达的一致性与逻辑性,支持大模型高效解析。
问答对丰富:包含大量结构化或半结构化的问答对(Q&A),覆盖定义类、因果类、流程类、对比类等 15 类问题类型,满足大模型微调对多样化知识输入的需求。
语义词库完备:配备油气行业专用语义词库,包含专业术语、同义词、缩写词、行业俚语等,支持大模型实现自然语言与业务节点数据资源的精准映射。
(3)技术实现路径
全息知识图谱构建:以五维五维业务本体模型为基础,构建涵盖地质体、井、设备、工艺、标准、问题、指标等多类实体,以及 “属于”“位于”“引起”“解决” 等多类关系的油气业务知识图谱。采用 “人工构建 + 自动抽取” 相结合的方式,通过 NLP 工具从技术文档、标准规范、历史案例中抽取实体与关系,经专家审核后融入图谱,确保知识的准确性与完整性。
标准化问答对生成:基于知识图谱设计多样化问答生成模板,包括定义类(如 “什么是低渗透砂岩油藏?”)、流程类(如 “钻井卡钻事故的处置流程是什么?”)、因果类(如 “导致井漏的主要原因有哪些?”)等 15 类模板,通过自然语言生成(NLG)技术批量产出问答对。同时,结合文献抽取法,从行业论文、操作手册中提取专业问答内容,补充人工编写的高质量问答对,形成多源融合的问答数据集。
行业语义词库建设:系统梳理油气行业专业术语,构建包含 3 万 + 核心术语的语义词库,明确术语的定义、同义词、缩写形式、应用场景等信息。建立术语与知识图谱实体的关联映射,支持大模型在解析自然语言时,精准定位对应的业务资源。
数据集优化处理:对生成的问答对与语义词库进行标准化处理,去除语义冲突、表述模糊的内容,按业务领域(地质、工程、安全、管理等)进行分类归档。采用标准 JSON Schema 格式存储,支持大模型微调接口直接加载,确保数据的可用性与适配性。
1、五维业务本体建模技术
基于业务坐标理论,以最小业务单元为核心,从对象域、业务域、工作域、专业域、业务过程域五个维度刻画油气业务逻辑,构建精确描述实体间空间、时间与逻辑关系的五维业务本体模型,为三类数据集提供统一的语义骨架,确保数据与业务的深度绑定。
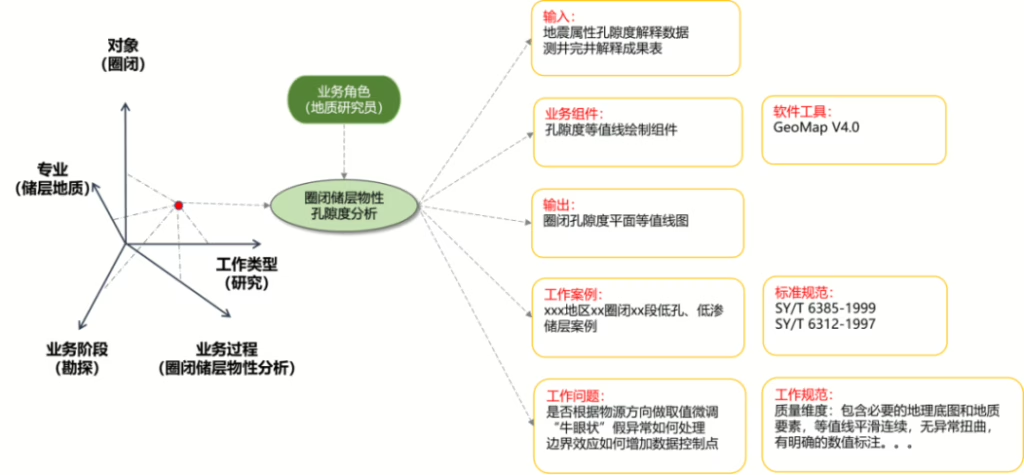
图2:五维业务本体建模
2、多源异构数据集成技术
融合传统 ETL 工具与现代数据湖架构,建立统一的数据描述结构与接入协议,通过格式转换引擎、语义映射层与统一接口服务,实现结构化、非结构化、时序数据、体数据等多类型数据的无缝融合,打破 “数据孤岛”。
3、各类数据业务化技术
原始数据是以各种形式存在的,在数据接入过程中及接入后需要对原始数据就行业务化处理,包括非结构化文档数据的自动业务化拆分技术、各种业务数据的萃取技术,如图形、表格自动生成、原始数据自动计算处理,如将测量深度转化为垂直深度等。所有这些数据处理成果都需要以五维业务本体模型的最小业务节点为单元就行管理和存储。
4、自动化数据质量评估技术
结合规则引擎与机器学习算法,构建动态质检系统。基于规则引擎实现 “油压> 套压” 等业务逻辑校验,利用孤立森林、3σ 法则等算法识别异常数据,输出量化的质量评分卡与整改建议,确保数据质量可控。
5、知识图谱与 NLP 融合技术
采用 Neo4j 等图数据库存储业务知识图谱,支持复杂关系查询与推理;融合 SpaCy、BERT-NER 等 NLP 工具,实现专业文档的知识抽取、问答对生成与术语标准化,为大模型微调提供高质量知识输入。
6、分布式存储与高效检索技术
采用 “时序数据库 + 向量数据库 + 图数据库” 的混合存储架构,时序数据库存储高频传感器数据,向量数据库存储文本特征用于相似性搜索,图数据库支撑知识图谱查询,确保各类数据的高效存储与快速检索。
基于上述研究方法和技术,为支撑三类高质量数据集建设,经过系统性的分析和研发,形成了一系列标准化服务体系、资源及软件工具产品,具体包括:
1、产品体系建设成果
构建了涵盖油气勘探、开发、生产、储运全流程的五维业务描述模型,开发了配套的模型维护工具,包含 4万 + 最小业务节点、1.6 万 + 标准数据集、15 万 + 标准数据项,覆盖勘探、开发、生产核心业务域。模型支持自定义扩展,可根据企业业务特点新增业务节点与数据项,配套工具提供模型可视化编辑、版本管理、冲突检测等功能。
2、客户应用价值
为某大型油公司数据湖平台提供了完整的业务描述模型支撑,解决了不同专业、不同系统间数据标准不一致的问题。具体而言,实现了业务描述模型构建、数据迁移、业务组件配置、查询搜索后台配置的全流程自动化,支撑多维度的数据查询、检索、百科等业务化应用。最终,跨部门数据协同效率提升 60% 以上,数据查询响应时间从分钟级缩短至秒级。
1、产品体系建设成果
形成了 “接入 – 清洗 – 标准化 – 质检 – 归档 – 监控” 全流程数据治理体系,开发了包含 6大类58小类数据质检工具,支持结构化数据(数据库表、CSV 文件等)、非结构化数据(技术文档、岩心图像等)、时序数据(传感器监测数据、生产曲线等)的全类型数据治理。内置 2000 + 行业专用质检规则,支持规则自定义配置与批量导入、质检任务自动执行,具备数据质量报告生成、问题溯源、整改跟踪等功能。
2、客户应用价值
已在 3 家大型油公司落地应用。如:某油公司通过该体系完成了 1.4 亿条勘探结构化数据、260 万份非结构化图文资料的存量历史数据清洗入湖,实现了历史数据资产的唯一、一致、完整、可信管理。最终,建立了以数据湖为核心的统一勘探数据资产管理体系,数据质检周期缩短50%以上。
1、产品体系建设成果
基于油气全息业务知识图谱,构建了覆盖 4 万 + 业务节点的标准问题问答对资源库,包含定义类、流程类、因果类、对比类等 15 类问题类型,累计产出高质量问答对 50 万 +。开发了问答对管理工具,支持问答对的批量生成、人工审核、分类归档、版本迭代与快速检索,具备语义相似度匹配与自动更新功能。
2、客户应用价值
为某油公司大模型微调提供了核心训练数据,大模型在专业知识问答场景的准确率从 30% 提升至 80%以上。支撑了油气实际数据问答查询、数据对比分析、问题自动诊断分析等日常业务场景。最终,业务人员获取专业知识的时间从平均 30 分钟缩短至 5 分钟以内。
1、产品体系建设成果
梳理整合了 SY/T、GB、API 等国内外油气行业标准规范,形成了包含 3000 + 核心业务规则的规则库,涵盖勘探开发、安全生产、储量计算、设备运维等核心领域。开发了智能规则抽取工具,支持从技术文档、标准规范、专家经验中自动抽取业务规则,形成标准化的规则表达式,支持与数据治理工具、业务系统的无缝集成,提供 100 + 标准 API 接口。
2、客户应用价值
某油公司应用该规则库与抽取工具,实现了钻完井报告、储量报告的自动生成与校核,报告编制时间从 5 天缩短至 1 天,报告校核准确率大幅提高,减少了 80% 的人工重复劳动。最终,在生产合规性检查场景中,通过规则引擎自动识别违规操作,隐患发现效率提升 3 倍,有效降低了生产安全风险。
1、产品体系建设成果
构建了涵盖 10 万 + 实体、50 万 + 关系的油气全息业务知识图谱,实体类型包括地质体、井、设备、圈闭、构造等 20 余类,关系类型包括 “属于”“位于”“引起”“解决”“参考” 等 15 类。开发了知识图谱管理平台,支持图谱的可视化编辑、实体关系查询、路径分析、推理演绎与动态更新,兼容 OSDU 服务架构。
2、客户应用价值
为某油公司构建了统一的知识中枢,实现了多源数据的业务化关联,数据关联查询效率提升 70%。支撑了小模型训练数据的自动聚合与大模型知识的结构化表达,小模型训练数据准备周期缩短 60%,大模型专业语义理解能力提升 50%。在跨部门协同场景中,通过图谱快速定位业务关联数据与资源,协同效率得到大幅提升。
1、产品体系建设成果
研发了面向小模型训练的高质量数据集构建平台(JuraML),集成了数据接入、特征提取、粒度对齐、自动化标注、数据集构建、质量评估等全流程功能。平台内置 20 余种专业特征提取算法,支持时间、深度、地层等多维度粒度对齐,可生成适配 TensorFlow、PyTorch 等主流框架的数据集格式,支持模型快速构建、复用与部署。
2、客户应用价值
已在某页岩气田、某海上油田落地应用,完成了储层预测、测录井自动解释、钻井事故预警等 8 类特征值数据提取,支撑 15 类智能场景的小模型训练。最终,储层识别模型准确率从 30% 提升至 70%,测井解释时间从 8 小时缩短至 40 分钟,显著提升了智能化应用的落地效果。
高质量数据集是油气行业迈向数字化、智能化的基石。本文系统梳理了面向三大应用场景——业务系统支撑、AI小模型训练、行业大模型微调——的高质量数据集分类体系,并提出了针对性的构建方法、管理机制与质量保障策略。
研究表明,数据治理不应局限于“数据清理”层面,而应上升至语义化、对象化、知识化的新阶段。以五维业务本地建模思想为指导,融合 OSDU 开放架构、特征仓库、知识图谱与AI生成技术,构建一个标准化、可持续更新、可智能调用的数据生态系统,将是实现油气全产业链智能升级的根本路径。
唯有如此,才能真正释放数据要素的价值,让人工智能在复杂、高风险、高投入的油气领域发挥最大效能。
参考文献
[1] 中华人民共和国国家能源局. SY/T 6025-2012 油气储量数据项名称规范 [S]. 北京:石油工业出版社,2012.
[2] Patidar S. Challenges and Solutions While Adopting OSDU in Oil & Gas[J]. International Journal of Financial Management Research, 2023, 11(3): 45-56.
[3] 王健,李洋,张磊。基于知识图谱的油田集输与注水系统能耗异常智能辅助决策方法 [J]. 中国石油大学学报 (自然科学版), 2025, 49 (2): 121-130.
[4] Dutta S, Roy A, Sen S. AI/ML Method for Seismic Well Tie Support on the OSDU Platform: Predicting Missing Wireline and Checkshot Data[J]. SPE Journal, 2025, 30(2): 897-912.
[5] Institute of Electrical and Electronics Engineers. IEEE 3821:2024 Standard for Digital Intelligent Comprehensive Energy Service Station Data Management System[S]. New York: IEEE Standards Association, 2024.
[6] 中油测井技术服务有限责任公司。地球物理测井高质量数据集构建与应用 [R]. 西安: 2025.
[7] Max180123. Chinese-PetroEngineering-Data-Distill-From-R1[DB/OL]. Hugging Face Datasets, 2025-08-27.
[8] 陈宏志,林秀峰。大语言模型在勘探开发数据治理中应用研究 [J]. 计算机技术与发展,2024, 34 (10): 134-139.
[9] 王丽娜,张伟,李强。油气 AI 组件化训练与高质量数据集适配技术 [J]. 石油钻采工艺,2025, 47 (4): 512-520.
关于我们